Cómo desarrollar algoritmos más seguros, transparentes y responsables
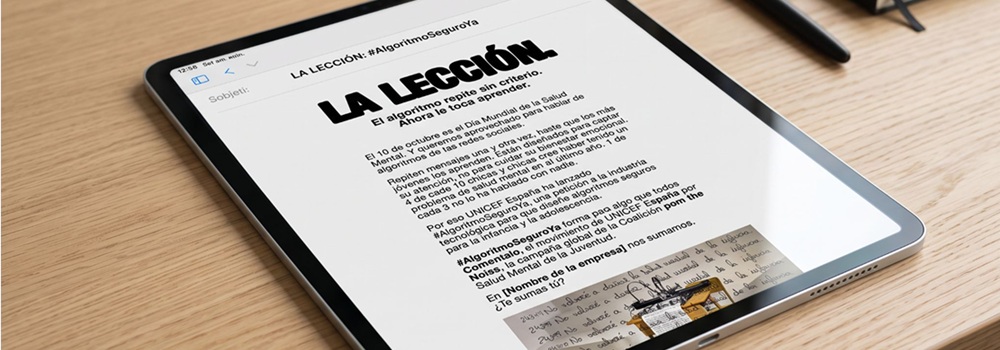
La reciente campaña de sensibilización ‘Algoritmo Seguro Ya’ impulsada por UNICEF España junto a la iniciativa ‘La Lección’, ha vuelto a poner sobre la mesa una realidad que trasciende el uso cotidiano de las redes sociales: los contenidos que reciben niños y adolescentes no aparecen de forma aleatoria, sino que están condicionados por sistemas algorítmicos diseñados para seleccionar, ordenar y recomendar información.
Los datos del informe Infancia, adolescencia y bienestar digital refuerzan la importancia del debate: el 92,5 % de los adolescentes en España utiliza redes sociales, casi un 60 % afirma que no quiere que un algoritmo decida por ellos y una parte significativa pasa varias horas al día frente a las pantallas. A ello se suma la preocupación por el bienestar emocional y la salud mental de los más jóvenes.
Detrás de estas cifras existe una cuestión tecnológica fundamental: los algoritmos de recomendación no son sistemas neutrales. Su comportamiento depende de los datos utilizados, los criterios definidos durante su diseño y, especialmente, de los objetivos para los que han sido optimizados.
¿Qué ocurre detrás de un algoritmo de recomendación?
Desde la ingeniería del software y la ciencia de datos, los motores de recomendación son sistemas analíticos diseñados para identificar patrones de comportamiento y anticipar qué contenido puede resultar más relevante para cada usuario.
Para ello, pueden analizar señales como los vídeos visualizados, las búsquedas realizadas, las interacciones, el tiempo de permanencia o incluso las pausas durante la navegación. A partir de estos datos, los modelos aprenden de las interacciones anteriores y ajustan progresivamente los contenidos que muestran. De esta forma, generan un nivel de personalización cada vez mayor.
Esta lógica de recomendación funciona mediante un proceso continuo de aprendizaje. Una interacción concreta genera una señal; el sistema interpreta esa señal como una posible preferencia y modifica las recomendaciones posteriores. Si el usuario vuelve a interactuar con contenidos similares, el modelo recibe nuevas evidencias que refuerzan esa asociación.
Es lo que puede dar lugar a bucles de retroalimentación por repetición: las recomendaciones influyen en lo que el usuario consume y, a su vez, ese consumo alimenta las siguientes recomendaciones. Así, una preferencia inicial puede adquirir progresivamente un mayor peso dentro del perfil que el sistema construye sobre cada persona.
Este mecanismo no es necesariamente negativo. La personalización permite reducir el volumen de información irrelevante y adaptar los servicios a los intereses de cada usuario. El riesgo aparece cuando determinados contenidos adquieren una presencia desproporcionada y disminuye progresivamente la diversidad de información recibida.
En usuarios especialmente vulnerables, como niños y adolescentes, comprender este funcionamiento resulta especialmente importante, ya que la exposición repetida a determinados mensajes puede tener un mayor impacto sobre sus percepciones, intereses o comportamientos.
Sesgos, amplificación y riesgos de un diseño centrado exclusivamente en la atención
Una vez entendido cómo aprende y personaliza un algoritmo de recomendación, la siguiente cuestión es qué objetivo se le pide optimizar. Aquí aparece una diferencia fundamental: no todos los riesgos proceden del aprendizaje del modelo o de los datos, sino también de las decisiones tomadas durante el diseño del sistema.
Uno de ellos es el sesgo de maximización de la atención o engagement bias. Aparece cuando métricas como el tiempo de permanencia, el número de clics, las interacciones o la recurrencia de uso se convierten en los principales indicadores de éxito. En esas condiciones, el sistema puede terminar favoreciendo contenidos capaces de generar respuestas emocionales intensas o mantener al usuario conectado durante más tiempo.
Un segundo fenómeno son las burbujas de información. A diferencia del bucle de retroalimentación explicado anteriormente, que describe cómo aprende el sistema, aquí hablamos de una posible consecuencia de esa dinámica: la exposición del usuario a un conjunto cada vez más limitado de temas, mensajes o perspectivas. La personalización deja entonces de ser únicamente una herramienta de relevancia y puede convertirse en un mecanismo de amplificación.
A ello se suman los patrones de diseño orientados a prolongar el uso, que no dependen directamente del algoritmo de recomendación. Elementos de interfaz como el scroll infinito o la reproducción automática reducen las interrupciones naturales de la navegación y facilitan un consumo continuado de contenidos. Son decisiones de diseño de producto que pueden reforzar los efectos del sistema de recomendación, aunque pertenezcan a una capa diferente de la plataforma.
Por tanto, conviene distinguir tres niveles: cómo aprende el algoritmo, qué objetivos se le pide optimizar y cómo está diseñada la experiencia de uso que lo rodea. Los bucles de retroalimentación pertenecen al funcionamiento del sistema de recomendación; los sesgos de atención y las burbujas informativas aparecen como posibles efectos de sus objetivos de optimización; y mecanismos como el scroll infinito o el autoplay forman parte del diseño de la plataforma.
Analizar estas capas por separado permite comprender mejor dónde se originan los distintos riesgos y evita atribuir exclusivamente al algoritmo efectos que también dependen de decisiones de diseño, métricas de negocio y patrones de interacción
De la regulación al diseño responsable de los sistemas de IA
La construcción de entornos digitales más seguros exige combinar regulación, diseño tecnológico y mecanismos de supervisión. Desde el punto de vista técnico, es posible desarrollar modelos que no midan su rendimiento únicamente en términos de interacción. Las funciones de optimización pueden incorporar variables relacionadas con la diversidad de contenidos, la privacidad, la seguridad o determinados criterios de protección, de manera que el éxito del sistema no dependa exclusivamente del tiempo de permanencia, la recurrencia de uso o el número de clics.
La incorporación de sistemas adecuados de verificación de edad, herramientas para limitar la exposición continuada a determinados contenidos o salvaguardas frente a patrones de uso potencialmente perjudiciales permite introducir criterios de seguridad desde la propia arquitectura del servicio.
Las técnicas de Inteligencia Artificial Explicable (XAI) permiten comprender mejor qué factores influyen en los resultados de un sistema y facilitan su evaluación, auditoría y supervisión. Cuando los sistemas de IA intervienen en procesos con consecuencias relevantes, mantener mecanismos de control humano permite revisar resultados, detectar comportamientos no deseados y evitar que decisiones sensibles dependan exclusivamente de procesos automatizados.
Avanzar hacia una IA más responsable implica, en definitiva, incorporar estos principios desde el diseño y no como una corrección posterior. Regulación, criterios de optimización, salvaguardas técnicas, explicabilidad y supervisión humana deben formar parte de una misma arquitectura orientada a reducir riesgos y reforzar la confianza en los sistemas digitales.
Tecnologías para una IA más segura, transparente y responsable
En Gradiant, investigamos y desarrollamos tecnologías que permiten aplicar inteligencia artificial y analizar grandes volúmenes de datos que incorporan desde el diseño requisitos de privacidad, seguridad, transparencia y control humano. Estas capacidades resultan especialmente relevantes en escenarios donde se trabaja con información sensible o donde las decisiones apoyadas por IA pueden tener consecuencias sobre las personas.
Una de nuestras líneas de trabajo se centra en el desarrollo de modelos y arquitecturas que incorporan principios de IA ética y transparente, técnicas de Inteligencia Artificial Explicable y mecanismos destinados a evitar que decisiones sensibles dependan exclusivamente de procesos automatizados. En este tipo de sistemas, la IA puede aportar información, análisis y apoyo a la toma de decisiones, pero la decisión final permanece bajo supervisión humana.
A esta aproximación se suman nuestras capacidades en User and Entity Behavior Analytics (UEBA) y Procesamiento del Lenguaje Natural (NLP), con las que desarrollamos algoritmos capaces de analizar grandes volúmenes de información, detectar anomalías e identificar patrones relevantes. Estas tecnologías permiten trabajar sobre fenómenos complejos presentes en entornos digitales y extraer información útil a partir de fuentes heterogéneas, apoyándose además en arquitecturas preparadas para el procesamiento masivo de datos.
La privacidad forma parte también de la propia arquitectura tecnológica. En Gradiant trabajamos con técnicas de análisis descentralizado y Aprendizaje Federado, que permiten desarrollar inteligencia compartida sin necesidad de centralizar ni exponer directamente las fuentes privadas de datos. De este modo, es posible combinar el aprovechamiento de la información con requisitos de privacidad, cumplimiento normativo y uso responsable de la IA.
Otra de nuestras líneas de trabajo se orienta al intercambio y análisis seguro de información. Tecnologías como AnonymiX permiten aplicar anonimización a datos personales, mientras que nuestras capacidades en espacios de datos facilitan entornos interoperables para compartir y explotar información de manera controlada. A ello se suman técnicas de aseguramiento de la calidad del dato y arquitecturas capaces de procesar grandes volúmenes de información heterogénea.
Estas capacidades se están aplicando, entre otros ámbitos, en PRESERVE, una iniciativa europea liderada por Gradiant orientada al desarrollo de herramientas de apoyo a autoridades de seguridad. El trabajo combina privacidad, IA ética, análisis descentralizado y procesamiento avanzado de datos para abordar escenarios como la prevención e investigación del abuso sexual de menores, la identificación de discursos de odio, el análisis de procesos de radicalización y la detección temprana de actividades vinculadas al tráfico de drogas.
En el caso de la protección de menores, por ejemplo, se desarrollan herramientas de análisis y visualización destinadas a ayudar a comprender relaciones entre posibles perpetradores, víctimas y redes asociadas, siempre dentro de un modelo de apoyo a la toma de decisiones y no de decisión automatizada.
Esta iniciativa europea, financiada por Horizonte Europa, permite llevar estas tecnologías a escenarios reales y validarlas junto a autoridades de seguridad de distintos países europeos.
Hacia algoritmos más seguros desde su propio diseño
La propuesta de UNICEF alrededor de #AlgoritmoSeguroYa pone de manifiesto que la protección de niños y adolescentes en los entornos digitales no puede depender únicamente de cómo utilizan las plataformas. También debemos preguntarnos cómo están diseñados los sistemas que seleccionan, priorizan y amplifican la información que reciben.
La tecnología permite avanzar hacia modelos diferentes: sistemas más transparentes, mecanismos de análisis que preservan la privacidad, arquitecturas descentralizadas, IA explicable y procesos en los que las personas mantienen el control sobre las decisiones. En Gradiant, trabajamos precisamente en estas capacidades para demostrar que es posible desarrollar inteligencia artificial avanzada sin renunciar a la privacidad, la seguridad y el uso responsable de los datos. Para construir entornos digitales más seguros es necesario incorporar estos principios desde el momento en que se inicia el diseño del algoritmo.
The project has received funding from the European Union’s Horizon Europe research and innovation programme under grant agreement No 101168309.