Datos sintéticos y modelos de lenguaje pequeños: Gradiant afronta dos nuevos retos de IA en IberLEF 2026
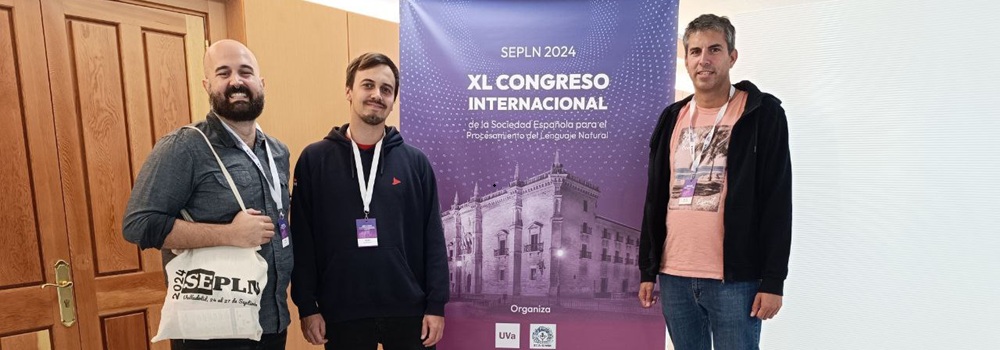
El equipo del centro tecnológico logra el primer puesto en REST-MEX 2026 con una propuesta basada en generación de datos sintéticos mediante modelos de lenguaje de menor tamaño
Los trabajos presentados en REST-MEX y GenSIE demuestran que el diseño del proceso, la arquitectura y la calidad del dato pueden ser tan determinantes como el tamaño del modelo
Gradiant participa en IberLEF 2026, que se celebra el próximo 22 de septiembre en el marco del Congreso SEPLN 2026 (León), con dos trabajos de investigación centrados en el uso de modelos de lenguaje de menor tamaño para abordar tareas complejas de inteligencia artificial. El equipo del centro tecnológico ha trabajado en generación de datos sintéticos y extracción de información estructurada, con resultados destacados como el primer puesto obtenido en el reto REST-MEX 2026.
IberLEF es una campaña anual de evaluación de sistemas de Procesamiento del Lenguaje Natural (PLN) en español y otras lenguas ibéricas. Cada edición reúne retos compartidos en los que equipos de investigación comparan métodos, resultados y aprendizajes. Los trabajos se presentan en el congreso anual de la Sociedad Española para el Procesamiento del Lenguaje Natural (SEPLN).
A lo largo de los años, estas tareas han abordado problemas como la detección de contenido dañino en internet, la adaptación automática de textos a lectura fácil, la creación de corpus para contextos sociosanitarios o el análisis de sentimientos. La evolución de la inteligencia artificial generativa ha añadido nuevos desafíos: detectar textos creados por IA, verificar la trazabilidad de las respuestas o comprobar hasta dónde pueden llegar los modelos de menor tamaño.
Un equipo de Gradiant formado por Anthea Silvia Sasdelli, David Sueiro, Álvaro Bueno, Alberto Vilches, Sindy Rocío Mojica, Pedro Alonso y Héctor Cerezo participan este año en IberLEF presentando dos trabajos: REST-MEX y GenSIE.
Nuestra experiencia en IberLEF con las nuevas tecnologías del lenguaje
Gradiant participa en IberLEF desde 2024, año en el que el equipo presentó Telescope, un sistema para detectar textos generados artificialmente que obtuvo el tercer puesto entre más de 50 participantes en IberAuTexTification. Posteriormente, en 2025 el equipo logró la tercera posición en PRESTA, una tarea de preguntas y respuestas sobre tablas en español. Nuestro sistema combinó modelos de lenguaje, generación de código Python y un proceso dividido en varios pasos para analizar las tablas y recuperar la respuesta. El método logró una exactitud del 85% sobre los datos de test. El trabajo completo puede consultarse en las actas de IberLEF 2025.
A mayores, Gradiant también tiene experiencia en talleres similares de ámbito internacional como el SemEval 2025, donde Álvaro Bueno presentó en Viena un trabajo de preguntas y respuestas sobre información en tablas, que fue el germen que posteriormente evolucionó al que se presentó para IberLEF, pero en un contexto de múltiples idiomas en vez de solo para español.
En 2026 nuestro equipo se enfrentará a dos nuevos retos: REST-MEX, centrado en la creación de un conjunto de datos sintético para entrenar un clasificador de reseñas turísticas, y GenSIE, que analiza el uso de modelos de lenguaje pequeños para extraer información estructurada a partir de textos. En ambos casos se presentarán artículos científicos que formarán parte de las actas de IberLEF 2026.
REST-MEX: datos sintéticos que suenan humanos
El reto REST-MEX 2026 propone generar reseñas turísticas sintéticas sobre los Pueblos Mágicos de México. El conjunto de datos debe incluir un máximo de 3.000 textos, distribuidos en cinco categorías de valoración ,de una a cinco estrellas, y servir para entrenar un modelo capaz de clasificar nuevas opiniones. Pedro Alonso, Ingeniero-Investigador Senior en Gradiant, nos cuenta en qué consiste el reto y el porqué de su complejidad:
“La dificultad no consiste únicamente en producir frases correctas. Para que el conjunto resulte útil, las reseñas deben cubrir experiencias variadas, utilizar un vocabulario diverso y reflejar distintas formas de expresarse en el mundo hispanohablante. También deben mantener una relación coherente entre el perfil del viajero, el itinerario y la puntuación asignada.
Nuestro sistema parte de perfiles de viajeros ficticios y de itinerarios simulados. A partir de esa información genera reseñas cercanas a las que podría escribir una persona después de un viaje. El proceso se divide en dos etapas principales:
- Generación a gran escala. Creamos un conjunto amplio de reseñas utilizando exclusivamente modelos de lenguaje de código abierto de 4B y 7B parámetros. Son modelos mucho más ligeros que las grandes alternativas comerciales.
- Selección por diversidad. Después aplicamos filtros basados en similitud semántica para seleccionar los 3.000 textos que aportan una distribución más diversa y útil para entrenar el clasificador.
La combinación de diferentes generadores y filtros dio lugar a varias entregas. La mejor obtuvo el primer puesto y en total cuatro de nuestras propuestas se situaron entre las cinco primeras posiciones de la clasificación de REST-MEX 2026.”
Esta experiencia confirma una idea clave: en la generación de datos sintéticos, el tamaño del modelo no lo es todo. Un diseño cuidadoso del proceso, una simulación coherente del contenido que se desea generar y una buena estrategia de filtrado pueden convertir modelos más ligeros en herramientas eficaces para crear conjuntos de datos de calidad.
GenSIE: extraer información compleja con modelos más pequeños
GenSIE plantea una pregunta diferente: ¿pueden los modelos de lenguaje pequeños extraer información estructurada con una precisión cercana a la de modelos mayores si se diseña bien el flujo de trabajo?
En cada prueba, el sistema recibe un texto y un esquema de salida con los campos que debe completar. David Sueiro, Ingeniero-Investigador en Gradiant, nos cuenta dónde reside la dificultad de este reto:
“La respuesta tiene que respetar una estructura definida, por ejemplo, un objeto JSON con entidades, relaciones o listas anidadas, aunque el modelo no haya sido entrenado específicamente para ese formato.
Para abordar el reto desarrollamos tres estrategias:
- Flujo estable. Divide la tarea en varias llamadas al modelo. Primero identifica las entidades relevantes; después marca esa información en el texto y, por último, extrae y verifica la respuesta. Esta secuencia ayuda a reducir las alucinaciones y fue la estrategia que obtuvo el mejor resultado de nuestras propuestas.
- Flujo experimental. Clasifica los campos del esquema según su naturaleza semántica y asigna a cada categoría una técnica de extracción específica. Algunos campos pueden resolverse mediante una pregunta directa; otros exigen elegir entre varias opciones o reconstruir estructuras más complejas.
- Flujo limitado. Incorpora un modo de razonamiento ajustable y un control adaptativo del tiempo para completar cada tarea dentro del límite de 60 segundos. El objetivo es dedicar más capacidad de cómputo a los casos difíciles sin superar las restricciones de la competición.
La clasificación final de GenSIE 2026 situó a Gradiant en octava posición. Aunque no alcanzamos los primeros puestos, el reto nos permitió identificar varios aprendizajes útiles. El flujo estable fue el más competitivo de nuestras propuestas.”
La principal conclusión es que el tamaño del modelo es solo una parte de la ecuación. La forma de dividir el problema, formular las instrucciones, destacar la información relevante y verificar la salida puede reducir la distancia entre modelos pequeños y grandes. Al mismo tiempo, trabajar con modelos distintos exige arquitecturas robustas: una configuración eficaz para un modelo no tiene por qué funcionar igual en otro.
¿Qué aprendizajes nos llevamos de esta experiencia?
- La calidad del dato se diseña. Generar muchos ejemplos es solo el primer paso; seleccionar los más diversos y coherentes determina su utilidad real.
- Los procesos modulares ofrecen más control. Dividir una tarea compleja en etapas facilita la verificación, la trazabilidad y la detección de errores.
- Un modelo más grande no sustituye necesariamente a una buena arquitectura. El diseño de las instrucciones, los filtros y los mecanismos de comprobación puede ser tan importante como el número de parámetros.
El 22 de septiembre Gradiant presentará estos trabajos en el taller IberLEF, dentro del Congreso SEPLN 2026, que se celebrará en León hasta el 25 de septiembre. Será una oportunidad para compartir resultados, contrastar enfoques con la comunidad investigadora y seguir mejorando tecnologías del lenguaje más eficientes, controlables y útiles.